

Analyse de fichiers journaux : l’outil SEO sous-estimé qui dit la vérité sur votre site
Laurent Lacoste Cyber sécurité
Quand je parle d’analyse de logs, beaucoup lèvent les yeux au ciel. “Encore un truc technique pour les développeurs…”
Erreur. Les fichiers journaux sont une des sources les plus directes pour voir ce qui atteint réellement votre infrastructure : requêtes, codes HTTP, ressources demandées, robots déclarés, erreurs et pics d’activité. Ils ne disent pas tout, mais ils montrent ce que le serveur, le proxy ou l’application a réellement observé.
Bienvenue dans un tour d’horizon simple, humain et actionnable de ce que j’utilise au quotidien pour optimiser des sites — du petit artisan au mastodonte e-commerce. Découvrez notre offre maintenance qui fait la différence.
Mise à jour août 2026
J’ai corrigé plusieurs raccourcis de la première version : le crawl budget concerne surtout les grands sites ou ceux qui changent très vite ; un User-Agent peut être usurpé ; Google-Extended n’est pas un crawler identifiable sous ce nom dans les logs ; et les logs serveur ne remplacent ni Search Console, ni les journaux du CDN/WAF, ni les logs applicatifs.
SOMMAIRE
C’est quoi un fichier journal ? (La version claire, pas la version RFC 1392)
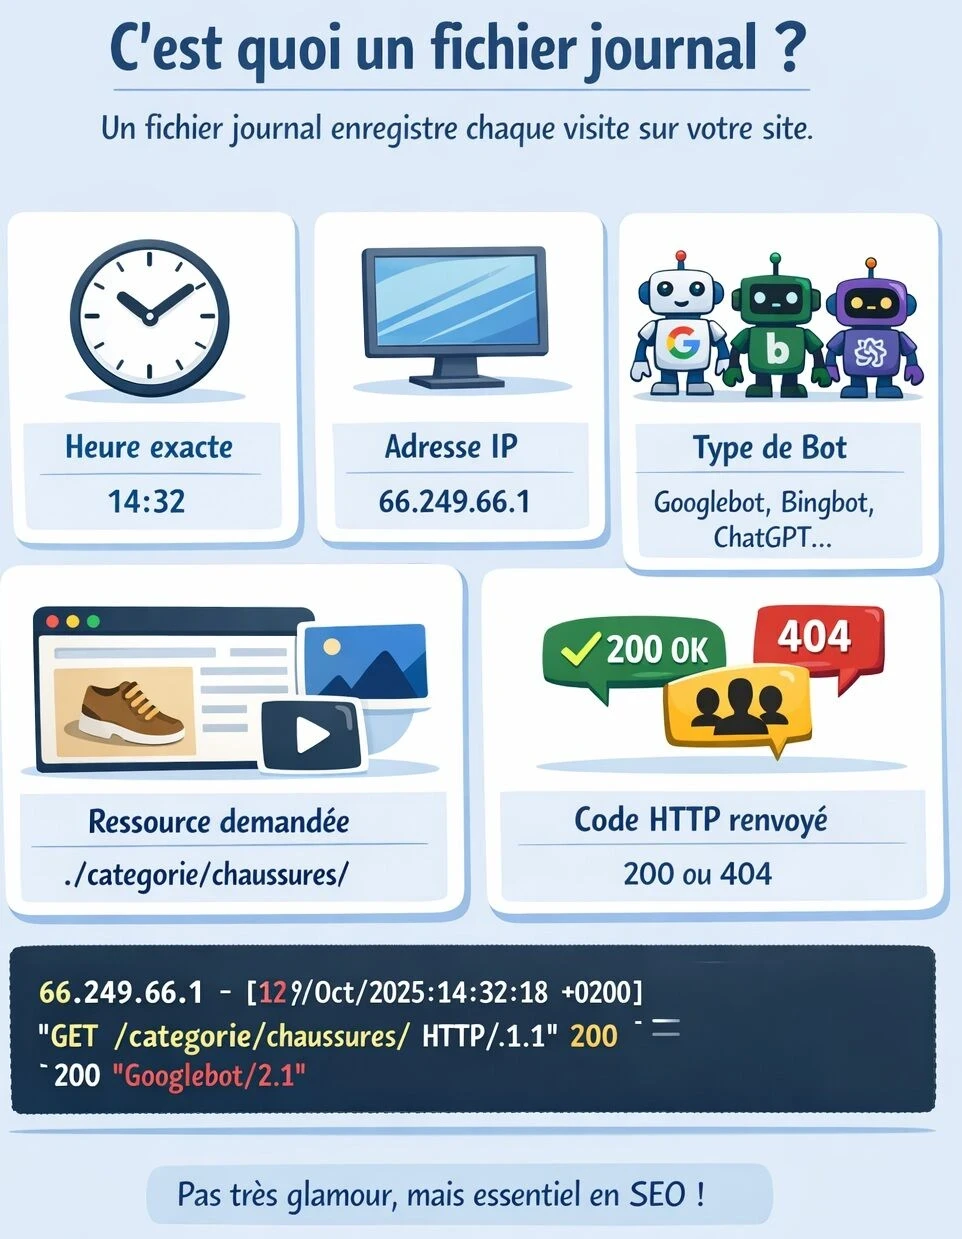
Un fichier journal (ou log serveur) contient une ligne à chaque fois que quelqu’un — humain ou robot — demande une ressource sur votre site.
Chaque ligne vous révèle :
- l’heure exacte
- l’IP qui a demandé la ressource
- le User-Agent déclaré par le client HTTP (Googlebot, navigateur, outil, bot, etc.) ;
- la ressource demandée : page HTML, image, script…
- le code HTTP renvoyé : 200, 301, 404…
Attention : un log web ne vous donne pas automatiquement l’identité réelle du robot. Un User-Agent peut être usurpé. Pour Googlebot, Google recommande de vérifier l’IP source via reverse DNS ou via ses plages IP publiées. Si le trafic passe par un CDN, un reverse proxy ou un WAF, il faut aussi vérifier que l’IP d’origine est bien transmise et journalisée.
Ça ressemble à ça :
66.249.66.1 - - [12/Oct/2025:14:32:18 +0200] "GET /categorie/chaussures/ HTTP/1.1" 200 5320 "-" "Googlebot/2.1"
Rien de très sexy, mais c’est la vérité terrain.
Et la vérité, en SEO, ça vaut de l’or.
Pourquoi analyser ses logs ? (Les bénéfices très concrets)
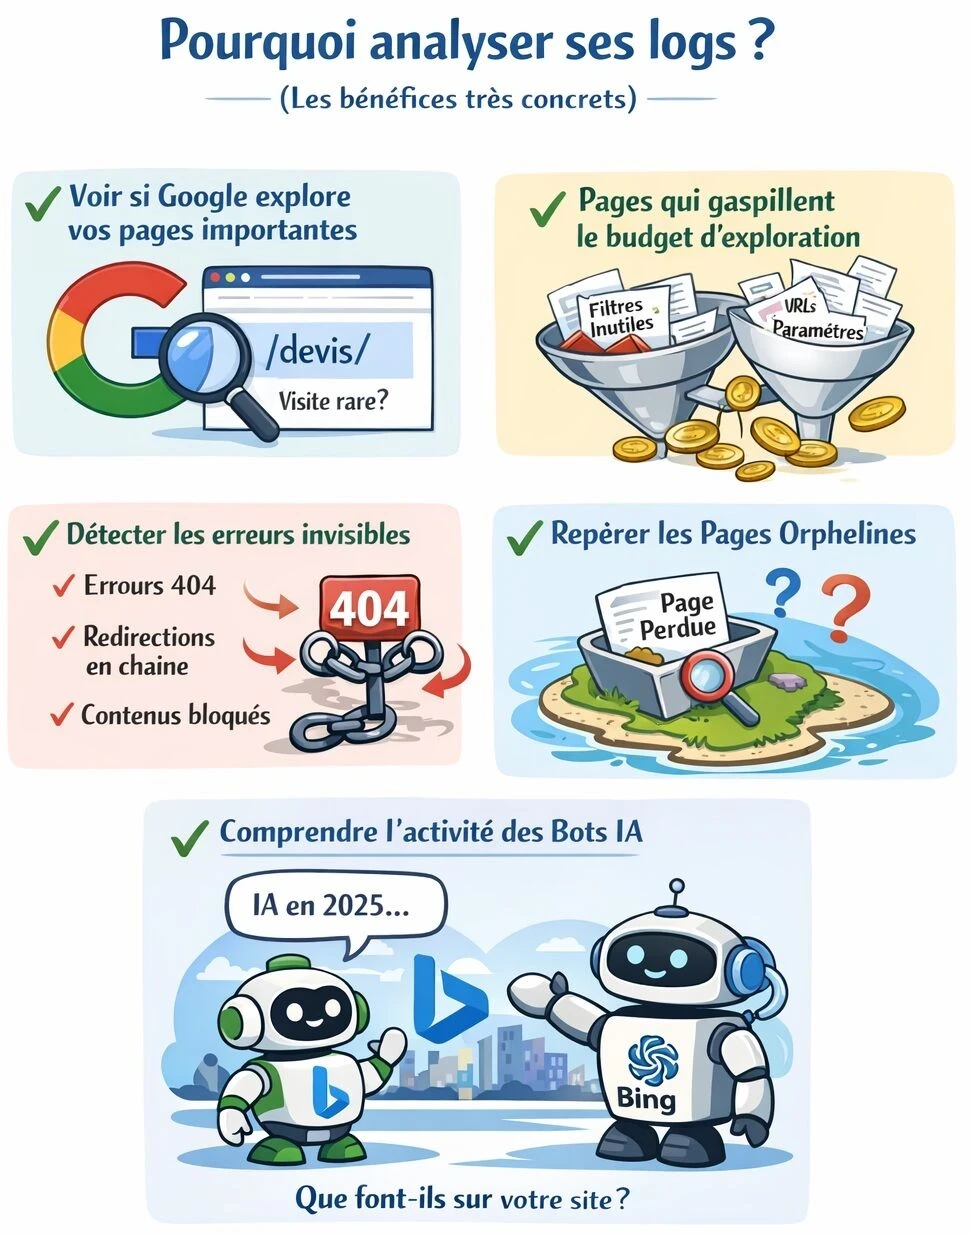
L’analyse des fichiers journaux vous permet de :
✔ Voir si Google explore vos pages importantes
Si votre page stratégique “/devis/” n’est explorée que deux fois par mois, c’est un problème.
✔ Repérer les URLs qui captent inutilement du crawl sur les sites où le sujet est réellement significatif
Pages de filtres, variantes produits, archives vides, URLs paramétrées inutiles…
✔ Détecter les erreurs invisibles dans un audit classique
- erreurs 404 fantômes
- redirections en chaîne
- contenus inaccessibles aux bots
- boucles de redirection générées par le CMS
✔ Repérer les pages orphelines
Oui, celles que personne n’a jamais linkées.
Les logs vous diront si un bot les trouve quand même… ou pas du tout.
✔ Comprendre comment les bots IA interagissent avec votre site
En 2026, plusieurs services d’IA utilisent des crawlers ou fetchers identifiables. Leur rôle varie : recherche, récupération à la demande, entraînement ou autre usage. Il faut donc éviter de mettre tous les bots IA dans le même panier.
À propos du crawl budget
Google réserve surtout ses recommandations avancées de crawl budget aux très grands sites, aux sites de 10 000+ URLs qui changent quotidiennement, ou aux sites qui ont beaucoup d’URLs “Découverte, actuellement non indexée”. Pour un petit site vitrine, les logs restent utiles, mais davantage pour diagnostiquer les erreurs, les robots et les redirections que pour “économiser du budget”.
Source : Google — Crawl Budget Management.
Si le sujet vous intéresse, voici des articles sur le même sujet
- Crawl Budget : les fondamentaux
- Les erreurs SEO techniques qui nuisent à votre référencement
- Comment savoir si votre site a été pénalisé par Google
- Optimiser un site Joomla pour le SEO : techniques & outils 2025
- Utiliser la Search Console pour améliorer réellement son SEO
Comment accéder à vos fichiers journaux ? (Simple et concret)
Trois options :
1. Via votre hébergeur
Selon l’hébergeur, l’accès peut se faire depuis le panneau d’administration, une console, un espace de logs ou une exportation. Les chemins et durées de conservation varient.
2. Via FTP
FileZilla ou un autre client SFTP/FTP peut être utilisé quand l’hébergeur expose réellement les fichiers. Les chemins dépendent d’Apache, Nginx, du conteneur ou de l’hébergeur.
3. Via votre développeur / admin système
Le plus safe si vous n’êtes pas à l’aise, surtout si un reverse proxy ou un CDN (Cloudflare, Nginx, Traefik) est en place.
Trente jours constituent souvent un bon point de départ. Sur un site peu crawlé ou saisonnier, une période plus longue peut être nécessaire.
Comment analyser ses logs ? (Méthode Laurent, éprouvée sur des années)
Je vous partage ma façon de faire, celle que j’utilise sur des sites e-commerce gourmands ou des sites institutionnels exigeants.
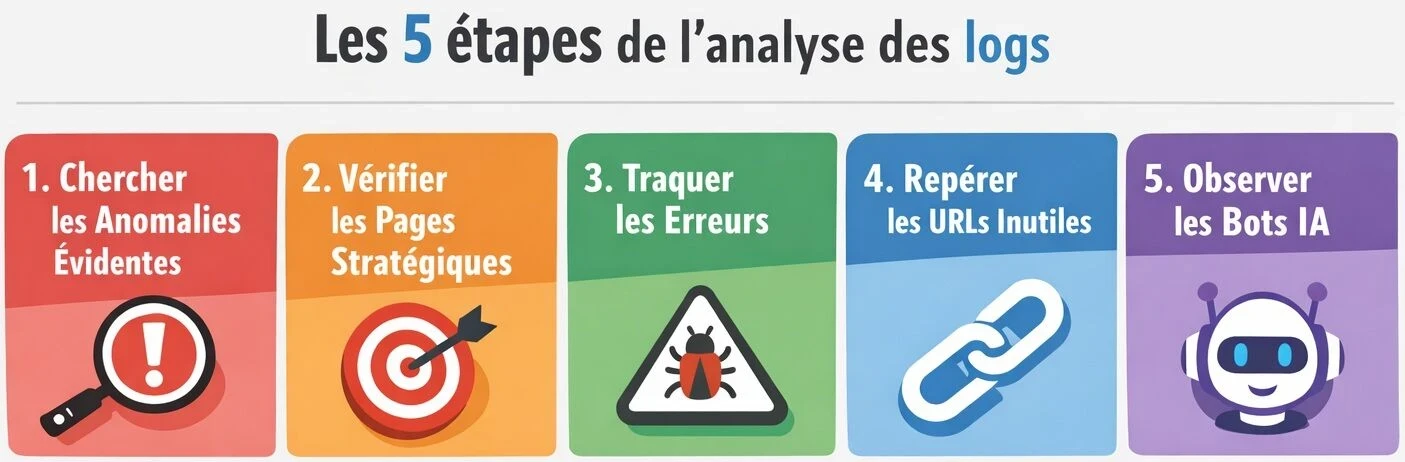
Étape 1 — Chercher les anomalies évidentes
Questions clés :
- Quelles sont les pages les plus explorées ?
- Quelles sont celles jamais visitées par Google ?
- Quels codes HTTP reviennent le plus ?
- Y a-t-il des pics de crawl anormaux ?
Les anomalies les plus fréquentes :
- pages filtres explorées 10x plus que les pages catégories
- redirections multiples non identifiées par le CMS
- Googlebot perdu sur des URLs internes non prévues
- ressources JS/CSS sollicitées de façon anormale ou en erreur — sans les bloquer aveuglément, car Google peut en avoir besoin pour rendre la page
Étape 2 — Vérifier le crawl des pages stratégiques
Posez-vous cette question simple :
“Est-ce que Google passe son temps où je veux qu’il passe son temps ?”
Exemples :
- si vous vendez des services → pages “Prestations”, “Contact”, “Devis”
- si vous êtes e-commerce → catégories + produits top ventes
- si vous êtes un artisan → pages locales : “Climatisation Toulouse”, “Dépannage Blagnac”…
Si elles sont peu explorées, je vérifie d’abord si c’est cohérent avec leur fréquence de mise à jour et leur indexation. Le crawl seul ne dit pas qu’une page doit devenir une priorité absolue.
Étape 3 — Traquer les erreurs (les vraies)
Les erreurs logs ≠ les erreurs que votre CMS détecte.
Les logs montrent :
- 404 récurrentes
- boucles 301 > 302 > 200
- pages interdites mais pourtant sollicitées
- ressources JS cassées qui empêchent le rendu
Une erreur récurrente, une longue chaîne de redirections ou des 5xx peuvent rendre l’exploration moins efficace. Je priorise selon la fréquence, les URLs touchées et l’impact réel.
Étape 4 — Repérer les URLs inutiles
Les logs adorent révéler ces horreurs :
- /?ref=facebook123
- /?sort=alpha&color=blue&price=low
- /old/ encore en ligne après la refonte
- /test/ visité 400 fois parce qu’un bot s’y perd
Action à choisir selon le cas : nettoyage de la génération d’URLs, suppression des liens internes inutiles, redirection, 404/410, noindex, canonical ou robots.txt. Ce ne sont pas des outils interchangeables.
Sur un grand site, cela peut libérer du crawl. Sur un petit site, le bénéfice principal est souvent une architecture plus propre et moins de bruit technique.
Étape 5 — Observer les bots IA
En 2026, c’est devenu un vrai sujet d’observation.
Vous verrez des choses comme :
- OAI-SearchBot — pour la découverte de contenus pouvant apparaître dans ChatGPT Search ;
- GPTBot — signal distinct utilisé par OpenAI pour l’accès à des contenus pouvant servir à l’amélioration de modèles ;
- PerplexityBot — crawler de recherche de Perplexity ;
- ClaudeBot — lorsqu’il apparaît dans vos journaux ;
- les crawlers et fetchers Google classiques, selon le produit concerné.
À ne pas chercher dans vos logs : Google-Extended n’a pas de User-Agent HTTP distinct. C’est un token robots.txt utilisé par Google pour contrôler certains usages liés à Gemini ; le crawl est effectué avec des User-Agents Google existants.
Sources : OpenAI — Publishers & Developers FAQ, Google — Common Crawlers, Perplexity — Crawlers.
Pourquoi c’est utile ?
Parce que ces accès permettent de savoir quels services viennent réellement chercher vos contenus et à quelle fréquence. C’est une donnée d’observation utile, mais elle ne prouve ni une citation, ni un classement, ni l’usage exact du contenu dans une réponse.
Comment éviter que Google explore n’importe quoi ?
robots.txt
Utile pour empêcher le crawl de zones sans intérêt lorsque c’est pertinent. Mais bloquer une URL dans robots.txt ne garantit pas sa désindexation. Si vous avez besoin que Google lise une directive noindex, la page doit rester accessible au crawler.
Balises canoniques
Utiles pour signaler une URL préférée parmi des contenus dupliqués ou très proches. Une canonical est un signal, pas une interdiction absolue de crawl, et elle ne doit pas être appliquée mécaniquement à toutes les variantes, facettes ou pages de pagination.
Nettoyage de la génération d’URLs
Sur les gros sites, c’est souvent le levier le plus efficace : éviter de créer et mailler des milliers d’URLs sans utilité, corriger les facettes, les paramètres, les calendriers infinis, la recherche interne ou les anciens chemins générés par le CMS.
Sitemaps et maillage interne
Pour les URLs importantes, gardez un sitemap propre, utilisez des dates lastmod fiables lorsque le contenu change réellement et assurez un maillage interne clair.
Sources : Google — Googlebot et Google — noindex.
À quelle fréquence analyser ses logs ?
Je préfère une fréquence liée au risque et au volume plutôt qu’un calendrier rigide : après une refonte, une migration, une chute d’indexation, une hausse de 5xx, un changement de CDN/WAF ou sur un gros site très actif, l’analyse doit être rapprochée. Sur un petit site stable, un contrôle ponctuel ou semestriel peut largement suffire.
Ce que les logs vous apportent réellement
En résumé :
- une vision serveur réelle des requêtes reçues ;
- des décisions techniques basées sur des occurrences et des volumes ;
- une meilleure compréhension du crawl sur les sites où le sujet est significatif ;
- une détection plus rapide de certaines erreurs, robots ou comportements anormaux.
Les logs sont une boussole technique très utile, mais je les croise toujours avec Search Console, le crawl du site, les données analytics et, côté sécurité, les journaux du CDN, du WAF et de l’application.
Logs & cybersécurité : une couche d’observation indispensable
Si je devais résumer 20 ans de gestion de serveurs et de Web Factory : quand quelque chose se passe mal, les logs permettent souvent de reconstruire ce qui s’est passé. Mais il faut regarder les bons journaux : CDN, WAF, pare-feu, serveur web, système et application.
Les fichiers journaux ressemblent davantage à un enregistreur de vol qu’à un bouclier : ils peuvent aider à détecter, corréler et comprendre un incident, mais ils ne remplacent ni le firewall, ni le WAF, ni le monitoring.
Détecter les attaques grâce aux logs
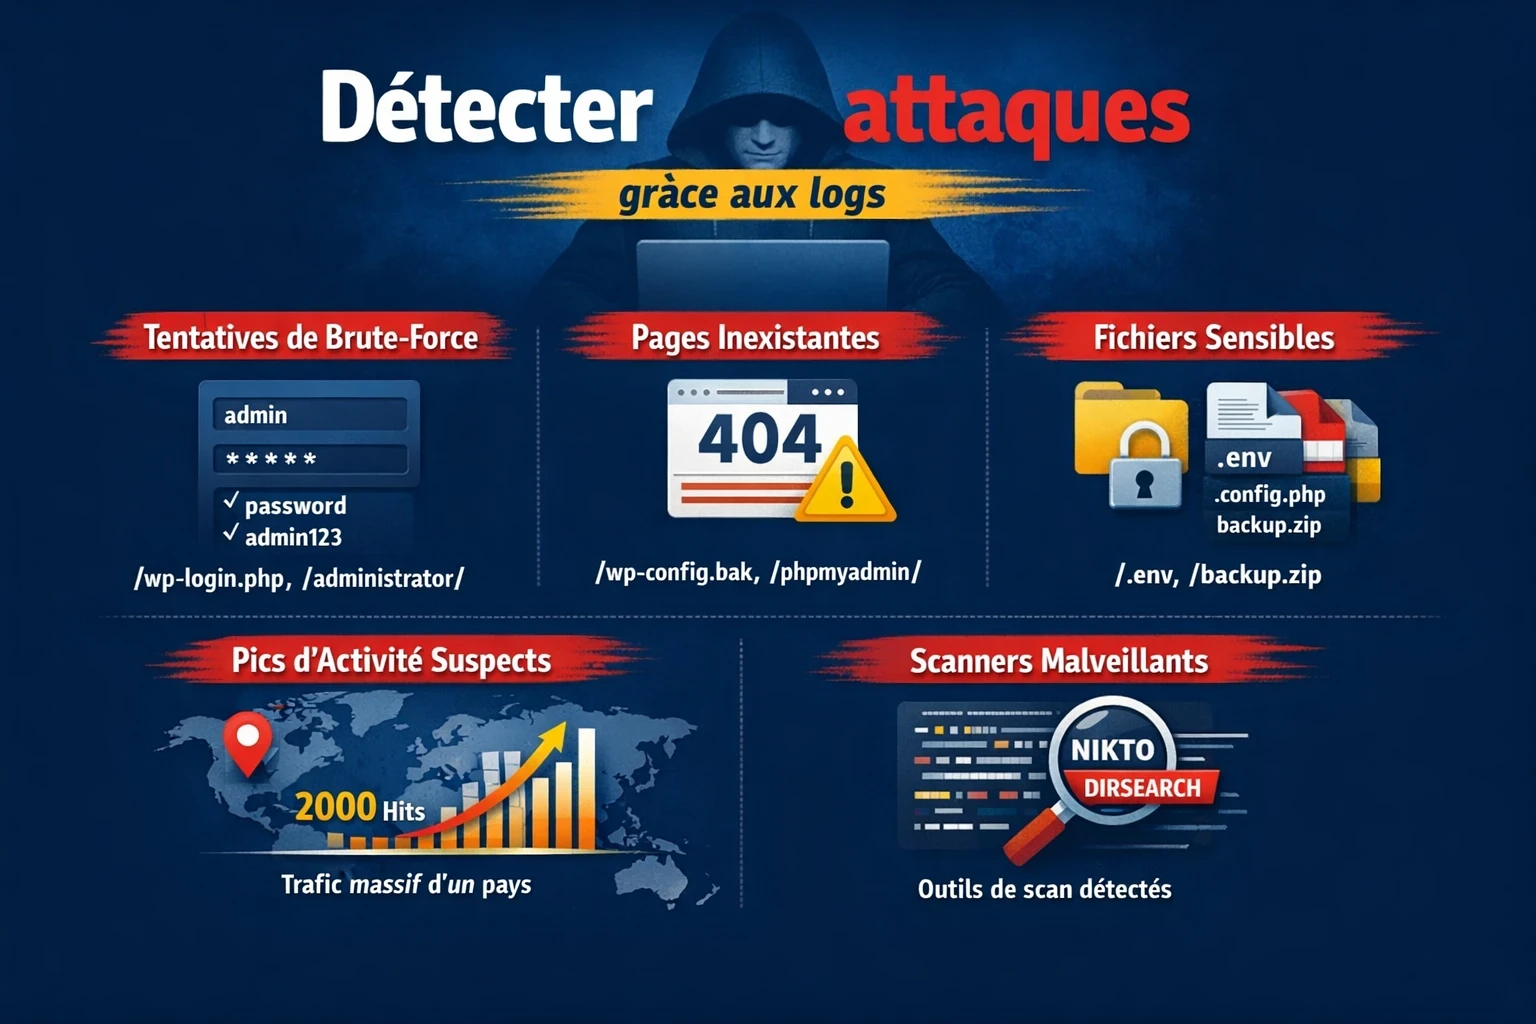
Voici quelques signaux que les logs peuvent faire apparaître. Pris isolément, ils ne prouvent pas toujours une attaque : c’est le pattern, la fréquence, la cible et le contexte qui comptent.
• Tentatives de brute-force (admin/wp-login/administrator…)
Une rafale d’appels sur :
/wp-login.php, /administrator/index.php, /user/login
→ mauvais signe.
Les bots testent des milliers de combinaisons pour entrer.
• Exploration massive de pages inexistantes
Exemple :
/wp-config.bak, /phpmyadmin/, /sqladmin/
→ ils cherchent une faille.
• Appels suspects sur des fichiers sensibles
Comme :
/.env, /config.php.old, /backup.zip
→ ces fichiers ne devraient jamais être publics.
• Pics d’activité soudains depuis un même pays ou un même ASN
Une IP qui génère 2 000 requêtes en 10 minutes mérite une vérification. Cela peut être une attaque, un scanner, un crawler légitime, un service de monitoring ou du trafic passé par un proxy. Je regarde l’ASN, les URLs, les méthodes HTTP, les codes de réponse et les journaux WAF avant de bloquer.
• Signatures de scanners ou d’outils comme Nikto, Skipfish, Dirsearch
Les User-Agents des attaquants ne sont pas toujours subtils.
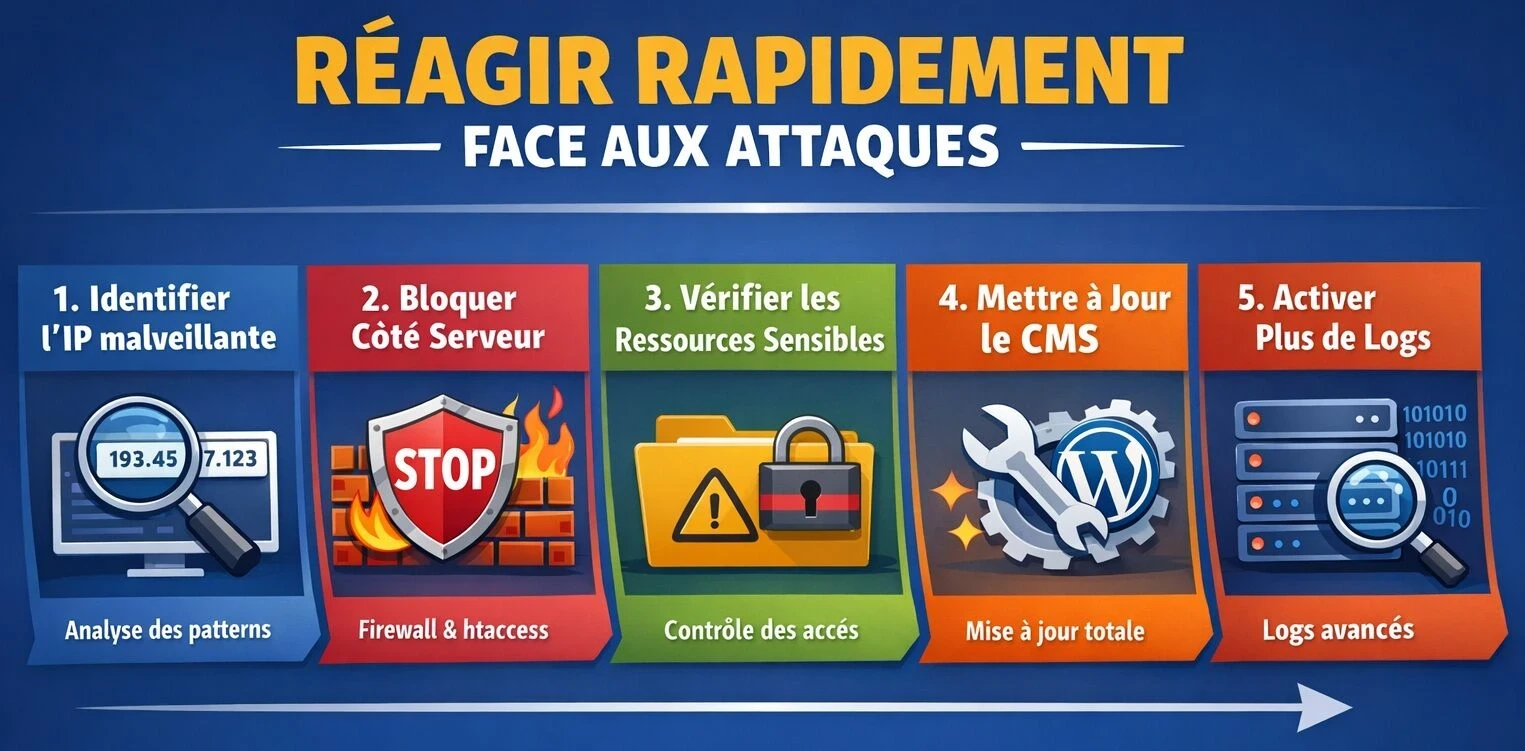
Comment réagir rapidement ? (La méthode Laurent, sans effacer les traces)
Étape 1 : Qualifier le signal
Analysez l’IP, l’ASN, le User-Agent, la méthode HTTP, les URLs visées, la fréquence, les codes de réponse et les éventuels événements WAF.
Étape 2 : Contenir si nécessaire
Rate limiting, règle WAF, blocage réseau, protection d’une route sensible ou désactivation temporaire d’un composant vulnérable. Avec un CDN, le blocage se fait souvent mieux en amont qu’au niveau d’un simple .htaccess.
- firewall (fail2ban, mod_security, Cloudflare)
- htaccess
- firewall applicatif
Étape 3 : Préserver les traces et vérifier l’impact
Avant de tout nettoyer, conservez les journaux et horodatages utiles. Vérifiez ensuite les accès, fichiers modifiés, comptes administrateurs et ressources sensibles.
- fichiers de configuration
- répertoires de sauvegarde
- scripts oubliés
Étape 4 : Corriger la cause et appliquer les correctifs
Les mises à jour sont importantes, mais elles viennent après la qualification et la préservation des éléments utiles. Corrigez la vulnérabilité ou le composant en cause dans un ordre maîtrisé.
Étape 5 : Augmenter temporairement la journalisation si nécessaire
Un niveau de détail supérieur peut aider, mais il faut le cadrer : les logs peuvent contenir des données personnelles ou des informations sensibles, et un mode debug trop bavard peut lui-même créer un risque.
Les attaques les plus fréquentes révélées grâce aux logs
Type d’attaque | Signature observable dans les logs | Risques |
Brute-force | centaines de POST sur /login | Tentative d’accès automatisée à qualifier |
Scan de vulnérabilités | Liste interminable de 404 sur fichiers sensibles | Reconnaissance / scan de surfaces exposées |
Injection SQL | URLs contenant ?id=1 OR 1=1 | Tentative d’injection ou payload suspect |
LFI / RFI | appels type /../../etc/passwd | Tentative de traversée de chemin / accès fichier |
Bots IA trop gourmands | milliers de GET sur des pages lourdes | Charge serveur ou crawl automatisé à surveiller |
DDoS léger | rafales d’accès sur une page légère | Pic de charge pouvant affecter la disponibilité |
Pourquoi les logs sont essentiels pour la sécurité
Les logs peuvent permettre de :
- détecter une activité anormale si les traces sont analysées activement ;
- reconstituer le déroulement d’un incident ;
- documenter les actions d’accès, de modification ou de suppression ;
- fournir des éléments utiles à une investigation, un prestataire cyber ou un contentieux.
Côté RGPD, la formulation doit être précise : les logs sont une mesure de sécurité et de traçabilité importante, mais leur simple existence ne “rend pas conforme”. La CNIL recommande une journalisation adaptée et, pour de nombreuses traces de sécurité, une conservation glissante comprise entre six mois et un an. Ces logs doivent eux-mêmes être protégés, minimisés et conservés pendant une durée justifiée.
Sources : CNIL — Tracer les opérations et ANSSI — architecture d’un système de journalisation.
Coupler logs + SEO pour sécuriser ET optimiser
Quand on met les deux ensemble, on voit des choses très utiles :
- une attaque brute-force peut réduire la vitesse du site → performance SEO en baisse
- des bots agressifs peuvent charger le serveur ; si cela dégrade la disponibilité ou le temps de réponse, Google peut réduire sa capacité de crawl
- des erreurs 5xx répétées peuvent gêner le crawl et, si elles persistent, avoir des conséquences sur l’exploration et l’indexation
- un composant compromis ou défaillant peut casser le rendu, injecter du contenu ou rendre certaines pages indisponibles
Les logs, c’est un système d’alerte précoce autant qu’un outil de diagnostic SEO.
Que retenir ? Les logs, c’est moche… mais c’est puissant.
Je le dis souvent à mes équipes :
“Le SEO moderne, c’est 50% stratégie, 30% technique… et 20% lecture de fichiers que personne ne veut ouvrir.”
L’analyse de logs n’est pas glamour, mais elle est redoutablement utile. C’est l’un des rares moyens de voir précisément ce que les crawlers demandent à votre serveur et ce que celui-ci leur renvoie. Pour savoir ce que Google indexe ou affiche dans Search, je la croise avec Search Console.
Vous voulez qu’on regarde vos logs ensemble ?
On peut faire ça autour d’un café, ou d’une bière (maison) si vous passez à Toulouse.
Besoin d’y voir clair dans vos logs (et dans votre SEO) ?
Les fichiers journaux racontent toute l’histoire de votre site : ce que Google voit, ce qu’il ignore, ce qui freine votre référencement… et parfois même ce qui menace votre sécurité.
Si vous voulez un diagnostic propre, technique et actionnable, je peux analyser vos logs, détecter les anomalies, optimiser votre budget d’exploration et renforcer la sécurité de votre site.
Une première lecture suffit souvent à repérer les anomalies les plus visibles. Pour relier proprement crawl, indexation, performances et sécurité, l’analyse doit ensuite être croisée avec les autres données du site.
Contactez-nous et on s’y met.
Promis : pas de jargon inutile, juste des solutions concrètes.
FAQ – Analyse de fichiers journaux & SEO (par Laurent Lacoste)
1. Qu’est-ce qu’un fichier journal (log serveur) en SEO ?
Un fichier journal est généré par une couche de votre infrastructure lorsqu’une requête ou un événement survient : visite, passage d’un crawler, appel d’une ressource, erreur, authentification, etc. Il montre ce que cette couche a réellement observé, avec les limites de sa configuration.
2. Pourquoi analyser ses logs améliore le SEO ?
Parce que les logs révèlent :
- les pages les plus (et les moins) explorées par Google,
- les erreurs invisibles dans les outils classiques,
- les redirections qui consomment du budget,
- les URLs inutiles qui diluent l’exploration,
- les contenus importants négligés par les robots.
En clair : les logs vous montrent ce que Google fait réellement, pas ce que vous espérez qu’il fasse.
3. À quelle fréquence faut-il analyser ses fichiers journaux ?
- petit site stable : contrôle ponctuel ou semestriel ;
- e-commerce, média ou gros catalogue : analyse plus régulière selon le volume ;
- refonte, migration, chute d’indexation, hausse de 5xx ou incident : immédiatement.
L’analyse régulière permet de réagir avant que les problèmes n’impactent votre visibilité.
4. Que peut-on découvrir dans les logs que l’on ne voit pas ailleurs ?
Beaucoup de choses, dont :
- des 404 récurrentes ignorées par le CMS,
- des robots d’IA qui explorent vos contenus,
- des boucles de redirections invisibles,
- des pages orphelines jamais découvertes par Google,
- des scripts cassés qui empêchent un bon rendu,
- des attaques en cours sur votre site.
Les logs sont un peu comme le “film de votre serveur”. On y voit tout.
5. Les logs permettent-ils d’améliorer l’exploration Google ?
Oui, surtout sur les sites où le volume d’URLs rend le crawl stratégique. Ils permettent d’identifier les zones sur- ou sous-explorées, les erreurs, les chaînes de redirections et certains paramètres générateurs d’URLs. Sur un petit site, le bénéfice est davantage diagnostique que budgétaire.
- quelles zones Googlebot sollicite réellement ;
- quelles URLs ou familles d’URLs produisent beaucoup d’erreurs ;
- où se trouvent des chaînes de redirections ou des paramètres inutiles ;
- quelles ressources sont en erreur ou génèrent une charge anormale.
C’est un levier puissant pour diagnostiquer l’exploration ; le crawl budget au sens strict devient surtout critique sur les grands sites.
6. Comment les logs aident-ils à détecter des attaques ?
Les logs montrent des signaux clairs :
- pics de requêtes,
- tentatives de brute-force,
- scans de vulnérabilités,
- exploration de fichiers sensibles,
- URLs suspectes ressemblant à des injections.
Ils constituent une source d’observation importante, mais pas toujours la première : selon l’architecture, un WAF ou un CDN peut bloquer la requête avant qu’elle n’atteigne le serveur web. Pour une analyse sécurité complète, il faut corréler plusieurs couches de logs.
7. Est-ce que je dois être développeur pour analyser mes logs ?
Pas forcément.
Mais avoir un œil expert aide à interpréter les anomalies, surtout pour :
- les schémas de crawl complexes,
- les redirections invisibles,
- les attaques sophistiquées,
- les interactions entre bots IA et SEO.
Un consultant technique peut analyser les logs, documenter les problèmes, et proposer des actions concrètes.
8. Les logs concernent-ils uniquement les gros sites ?
Non.
Même un petit site peut avoir :
- des pages peu explorées,
- des erreurs cachées,
- des paramètres d’URL inutiles,
- des robots agressifs.
Même un petit site peut tirer profit d’un audit ponctuel, notamment après une refonte, en cas d’erreurs récurrentes ou d’activité robot anormale.
9. Combien de lignes de logs faut-il analyser pour obtenir des insights ?
En général :
- 30 jours constituent souvent un bon point de départ ;
- pour un faible volume, un site saisonnier ou une analyse avant/après migration, 60 à 90 jours peuvent être plus utiles.
L’essentiel est de disposer d’un panel suffisamment large pour voir les patterns.
10. Est-ce que TooNetCreation peut analyser mes logs ?
Oui.
Nous proposons :
- un audit technique complet,
- une analyse du crawl Google,
- un diagnostic sécurité,
- des recommandations concrètes (corrections + priorisation),
- un plan d’optimisation du budget d’exploration,
- un suivi des améliorations.
C’est l’un des domaines où notre expertise technique fait réellement la différence.
Prêt à concrétiser votre projet ?
Posez nous toutes vos questions et nous vous aiderons à y voir plus clair.


